 O
Open LLM Leaderboard
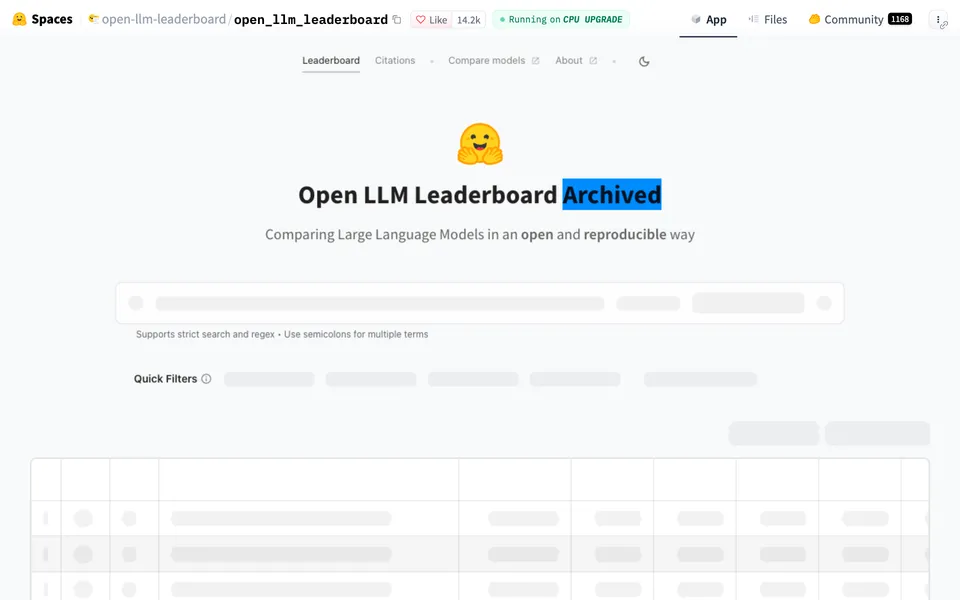
Open LLM Leaderboard 是一款面向开源模型与评测领域的实用在线平台,核心提供Hugging Face推出的开源大模型排行榜单等功能支持。
产品定位与核心价值
在 AI 编程 · 开源模型与评测 赛道中,Open LLM Leaderboard 面向大模型算法研究员、AI 架构选型负责人、本地私有化部署极客与开源贡献者打造了专业化的解决方案,核心能力覆盖开源模型与评测、AI编程、开源生态等关键维度。该产品通过官方站点 huggingface.co 对外提供服务,重点解决日常业务流中开源模型版本繁杂真假难辨、本地量化运行配置复杂以及缺乏客观中立的基准评测数据参考的问题。
无论是个人创作者的日常独立作业,还是企业团队的标准化协作流程,均可通过 Open LLM Leaderboard 的模块化功能缩短从需求输入到结果交付的周期,显著降低试错与制作成本。
核心功能与产品特性
- 核心价值主张:Open LLM Leaderboard 是一款面向开源模型与评测领域的实用在线平台,核心提供Hugging Face推出的开源大模型排行榜单等功能支持。
- 开源大模型与微调权重托管仓库:汇聚全球前沿文本、视觉、语音与多模态开源基座模型、LoRA 权重及高质量数据集。
- 多维度客观评测基准与盲测竞技场:提供涵盖代码、数理、中文理解、长上下文与视觉推理的权威排行榜与真人盲测对比。
- 轻量化本地推理与一键量化运行:支持在个人 Mac/PC 或内网服务器上零配置拉取并流畅运行 GGUF/MLX 等量化开源模型。
典型应用场景与实操指南
- 场景 1 · 企业技术选型前的模型能力横评:结合 Open LLM Leaderboard 的功能特性,查阅权威评测榜单在目标任务维度(如代码生成、中文抽取或函数调用)的真实得分与成本曲线,锁定最优基座。
- 场景 2 · 数据不出域的本地开源模型私有部署:结合 Open LLM Leaderboard 的功能特性,从开源模型库挑选合适参数量的量化版本,借助本地推理引擎在离线环境中搭建完全私密的 AI 服务。
同赛道工具横向对比与选型参考
在 开源模型与评测 领域进行工具选型时,建议重点评估开源协议可商用性(Apache-2.0 / MIT)、评测数据集防刷榜公信力以及本地硬件显存资源占用比。除 Open LLM Leaderboard 外,以下同领域代表性工具也常被用于对比选型:
- LLMEval3:LLMEval3 是一款面向开源模型与评测领域的实用在线平台,核心提供由复旦大学NLP实验室推出的大模型评测基准等功能支持。
- H2O EvalGPT:H2O EvalGPT 是一款面向开源模型与评测领域的实用在线平台,核心提供H2O.ai推出的基于Elo评级方法的大模型评估系统等功能支持。
- PubMedQA:PubMedQA 是一款面向开源模型与评测领域的实用在线平台,核心提供生物医学研究问答数据集和模型得分排行榜等功能支持。
如果您的核心诉求集中在「开源模型与评测」的高效落地,优先建议直接体验 Open LLM Leaderboard;若涉及跨阶段或多模态组合工作流,可搭配上述同类工具协同使用。
常见问题解答 (FAQ)
Q1:Open LLM Leaderboard 主要适合哪些用户群体使用?
A:Open LLM Leaderboard 主要面向大模型算法研究员、AI 架构选型负责人、本地私有化部署极客与开源贡献者,核心用于解决开源模型版本繁杂真假难辨、本地量化运行配置复杂以及缺乏客观中立的基准评测数据参考的问题。
Q2:如何访问和使用 Open LLM Leaderboard?
A:您可以通过点击当前页面右上角的「立即访问官网」按钮直达 huggingface.co 官方入口,或点击「手机扫码访问」在移动端浏览器中打开体验。
Q3:在 开源模型与评测 领域,有哪些与 Open LLM Leaderboard 相关的同类工具推荐?
A:在 开源模型与评测 分类下,与 Open LLM Leaderboard 定位相近的代表性工具还包括 LLMEval3、H2O EvalGPT、PubMedQA 等,您可根据具体业务场景与操作习惯自由选择。
#8082更新于 2026-11-12T03:15:00Z